
Участник:Артем Таран/Графо-ориентированный алгоритм кластеризации CHAMELEON: различия между версиями
ShimchikN (обсуждение | вклад) м test |
Kronberg (обсуждение | вклад) Нет описания правки |
||
| (не показано 137 промежуточных версий 3 участников) | |||
| Строка 1: | Строка 1: | ||
{{Assignment|Algoman|Kronberg}} | |||
{{algorithm | |||
| name = Графо-ориентированный алгоритм кластеризации CHAMELEON | |||
| serial_complexity = <math>O(n^2+nm+m^2log(m))</math> | |||
| pf_height = <math>O(n + log(n) + mlog(m) + m^2log(m))</math> | |||
| pf_width = <math>O(n)</math> | |||
| input_data = <math>\frac{n (n - 1)}{2}</math> | |||
| output_data = <math>n</math> | |||
}} | |||
Статью подготовили: [[Участник:Артем_Таран|Артём Таран Иванович]] (разделы 1.1 - 1.10, 2.7), [[Участник:ShimchikN|Шимчик Никита Владимирович]] (разделы 1.1 - 1.10, 2.7). | |||
== Свойства и структура алгоритма == | == Свойства и структура алгоритма == | ||
=== Общее описание алгоритма === | === Общее описание алгоритма === | ||
Кластеризация — многомерная статистическая процедура, выполняющая сбор данных, содержащих информацию о выборке объектов, и затем упорядочивающая объекты в сравнительно однородные группы (кластеры) с минимизацией межкластерного сходства и максимизацией внутрикластерного сходства. | |||
Графо-ориентированный алгоритм кластеризации CHAMELEON<ref name="rt">http://www-users.cs.umn.edu/~han/dmclass/chameleon.pdf</ref> - алгоритм, который измеряет сходство двух кластеров на основе | |||
динамической модели. В процессе кластеризации два кластера объединяются, только если показатели взаимосвязанности и близости между двумя кластерами являются высокими по отношению к показателям внутренней взаимосвязанности кластеров и близости элементов внутри этих кластеров. Процесс слияния с использованием динамической модели, использующийся в данном алгоритме облегчает открытие | |||
природных и однородных кластеров. Методология динамического моделирования кластеров, использующаяся в CHAMELEON, | |||
применима ко всем типам данных, для которых может быть построена матрица подобия. | |||
Следует отметить, что конечное число кластеров не задаётся явным образом и зависит как от выбора параметров алгоритма, так и от внутренней структуры входных данных. | |||
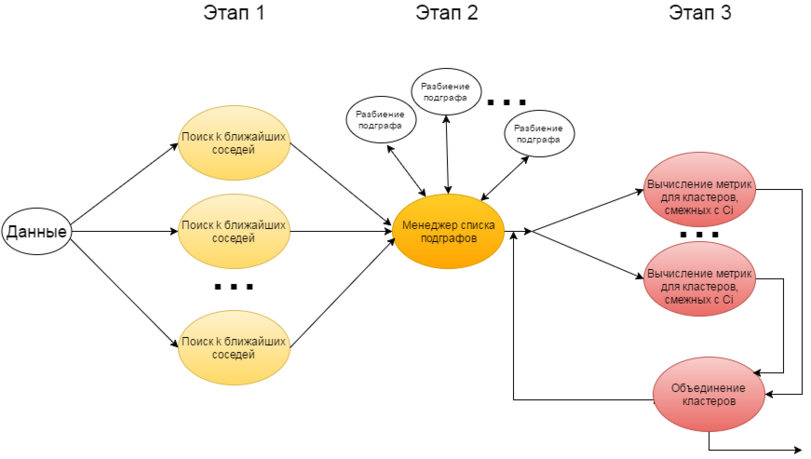
Алгоритм кластеризации CHAMELEON включает в себя три этапа: | |||
1) Построение графа, путём добавления рёбер по принципу k ближайших соседей. | |||
2) Выделение множества сравнительно малых связных подграфов. | |||
3) Формирование набора кластеров, на основе множества подграфов, полученных на предыдущем этапе. | |||
[[Файл:Графы k ближайших соседей.jpg|1000px|thumb|center|Графы k ближайших соседей: 1) объекты в пространстве, 2) граф по принципу 1-го ближайшего соседа, 3) граф по принципу 2-го ближайшего соседа, 4) граф по принципу 3-х ближайших соседей<ref name="rt">http://www-users.cs.umn.edu/~han/dmclass/chameleon.pdf</ref>]] | |||
=== Математическое описание алгоритма === | === Математическое описание алгоритма === | ||
==== Данные ==== | |||
* '''Исходные данные''': множество из <math>n</math> точек <math>V = \{v_{i}\}</math> в метрическом пространстве, которое может быть задано в виде треугольной матрицы расстояний <math>A</math> размера <math>n\times n</math>; натуральное число <math>k</math>, используемое в качестве параметра алгоритма поиска k ближайших соседей. | |||
* '''Промежуточный результат после первого этапа''': граф <math>G = (V, E)</math>, полученный путём соединения каждой точки с её <math>k</math> ближайшими соседями. | |||
* '''Промежуточный результат после второго этапа''': разбиение множества <math>V</math> на набор <math>K = \{K_{i}\}</math> попарно непересекающихся связных подмножеств, из которого образуется взвешенный граф <math>G_{2} = (K, E_{2})</math>. | |||
* '''Промежуточный результат после третьего этапа''': итоговое разбиение множества вершин графа <math>G_{2}</math> на набор кластеров <math>C = \{C_{i}\}</math>. | |||
* '''Вычисляемые данные''': n-мерный вектор <math>v</math> (элементы <math>v_{i}</math>), показывающий отображение исходного множества точек на набор кластеров <math>C</math>. | |||
==== Определения ==== | |||
* ''Абсолютная взаимная связность между парой кластеров <math>C_{i}</math> и <math>C_{j}</math>'' определяется как сумма весов ребер, соединяющих вершины, принадлежащие <math>C_{i}</math> с вершинами из <math>C_{j}</math>. Эти ребра, фактически, входят в разделитель ребер графа, состоящего из кластеров <math>C_{i}</math> и <math>C_{j}</math>, и разбивающим его на подграфы <math>C_{i}</math> и <math>C_{j}</math>. Обозначается эта величина как | |||
<math>EC_{(C_{i},C_{j})}</math>. Внутреннюю связность <math>EC_{C_{i}}</math> кластера <math>C_{i}</math> можно вычислить как сумму ребер, входящих в разделитель ребер, разбивающий <math>C_{i}</math> на два совершенно равных подграфа. | |||
* ''Относительная взаимная <math>RI_{(C_{i},C_{j})}</math> связность пары кластеров <math>C_{i}</math> и <math>C_{j}</math>'' определяется формулой: | |||
<math>RI_{(C_{i},C_{j})} = \frac{2*|EC_{(C_{i},C_{j})}|}{|EC_{C_{i}}|+|EC_{C_{j}}|}</math> | |||
Учитывая значения относительной взаимной связности, можно добиться получения кластеров разного размера, формы и плотности, то есть общего внутреннего сходства. | |||
* ''Абсолютное взаимное сходство между парой кластеров <math>C_{i}</math> и <math>C_{j}</math>'' подсчитывается как среднее сходство между соединенными вершинами, принадлежащими <math>C_{i}</math> и <math>C_{j}</math> соответственно. Эти соединения обусловлены предыдущим разбиением общего графа, полученного на матрице сходства. | |||
* ''Относительное взаимное сходство <math>RC_{(C_{i},C_{j})}</math> между парой кластеров <math>C_{i}</math> и <math>C_{j}</math>'' определяется как абсолютное сходство между этой парой кластеров, нормализованное с учетом их внутреннего сходства и вычисляется по формуле: | |||
<math> RC_{(C_{i},C_{j})}= \frac{S_{EC_{(C_{i},C_{j})}}}{\frac{|C_{i}|}{|C_{i}+C_{j}|}*S_{EC_{(C_{i})}}+\frac{|C_{i}|}{|C_{i}+C_{j}|}*S_{EC_{(C_{j})}}}</math>, | |||
где <math>S_{EC_{(C_{i})}}</math> и <math>S_{EC_{(C_{i})}}</math> - средние веса ребер (значения сходства), принадлежащих разделителю ребер кластеров <math>C_{i}</math> и <math>C_{j}</math> соответственно, | |||
и <math>S_{EC_{(C_{i},C_{j})}}</math> - средний вес ребер, соединяющих вершины <math>C_{i}</math> с вершинами <math>C_{j}</math>, причем ребра принадлежат разделителю ребер <math>EC_{(C_{i})}</math>, определенному ранее. | |||
Далее, алгоритм применяет агломеративную иерархическую кластеризацию с использованием вышеозначенных показателей. Причем существует две стратегии их учета. Первая подразумевает наличие некоторых пороговых значений <math>T_{RI}</math> и <math>T_{RC}</math>. В соответствии с этой стратегией, алгоритм для каждого кластера <math>C_{i}</math> проверяет, отвечают ли смежные (наиболее близкие) ему кластеры условиям: | |||
*<math>RI_{(C_{i},C_{j})} \geqslant T_{RI}</math> | |||
*<math>RC_{(C_{i},C_{j})} \geqslant T_{RC}</math> | |||
Если более одного смежного кластера отвечает этим условиям, то алгоритм выбирает для объединения наиболее связный кластер (граф), то есть такой кластер <math>C_{j}</math>, с которым у кластера <math>C_{i}</math> получается наибольшая абсолютная взаимная связность. По завершению прохода по всем кластерам, созданные таким образом пары объединяются. Параметры <math>T_{RI}</math> и <math>T_{RC}</math> могут использоваться для изменения характеристик получаемых кластеров. | |||
Вторая стратегия заключается в использовании специальной функции, объединяющей понятия относительной взаимной связности и относительного взаимного сходства. На каждом шаге выбираются те кластеры для объединения, которые максимизируют эту функцию: | |||
<math>RI_{(C_{i},C_{j})}*RC_{(C_{i},C_{j})}^\alpha</math>, | |||
где <math>\alpha</math> выбирается пользователем. Если <math>\alpha > 1 </math>, то алгоритм придает большее значение относительному взаимному сходству, а если <math>\alpha < 1 </math>, то большее значение имеет относительная взаимная связность. Разумеется, данный подход позволяет получить полную дендрограмму кластерного анализа<ref name="rty">http://studopedia.ru/7_41934_algoritm-dinamicheskoy-ierarhicheskoy-klasterizatsii-CHAMELEON.html</ref>. | |||
=== Вычислительное ядро алгоритма === | === Вычислительное ядро алгоритма === | ||
На первом этапе работы алгоритма вычислительным ядром можно считать процесс нахождения k ближайших соседей для каждой отдельной вершины. | |||
На втором этапе работы алгоритма вычислительным ядром является поиск разбиения графа на два подграфа с минимизацией разделителя рёбер графа. | |||
На третьем этапе работы алгоритма вычислительным ядром является расчёт <math>EC_{(C_{i},C_{j})}</math>, <math>RC_{(C_{i},C_{j})}</math> и <math>RI_{(C_{i},C_{j})}</math> для пары смежных кластеров, а также их слияние. | |||
=== Макроструктура алгоритма === | === Макроструктура алгоритма === | ||
Алгоритм CHAMELEON выполняется в 3 этапа, последовательных относительно друг друга. Каждый этап соответствует отдельному алгоритму. | |||
* Макрооперацией на первом этапе является процедура выделения k ближайших соседей. | |||
* Макрооперацией на втором этапе является процедура разбиения наибольшего подграфа на каждой итерации. | |||
* Макрооперациями на третьем этапе являются процедуры вычисления метрики для принятия решения об объединении кластеров и объединение кластеров на каждой итерации. | |||
=== Схема реализации последовательного алгоритма === | |||
* Первый этап (псевдокод): | |||
integer n; // Количество точек. | |||
integer k; // Параметр k | |||
integer A[n][n]; // Верхняя треугольная матрица расстояний между точками. | |||
integer E[n][n]; // Верхняя треугольная матрица рёбер графа G - изначально инициализирована нулями. | |||
foreach (integer i in (1,n-1) ) { | |||
integer Neighbours[k]; // матрица, используемая хранения ближайших соседей | |||
integer countN = 0; | |||
foreach (integer j in (i+1, n) ) { | |||
// Заполняем матрицу Neighbours, добавляя новые элементы и увеличивая счётчик countN. | |||
// Когда countN станет равен k, новые элементы будут вставляться на место старых, либо отбрасываться. | |||
} | |||
foreach (integer j in (0, countN) ) { | |||
E[min(i,j), max(i,j)] = 1; | |||
} | |||
} | |||
return E; | |||
* Второй этап: | |||
[[File:Диаграмма_шаг_2.png]] | |||
* Третий этап: | |||
[[File:Chameleon_stage_3.png|611px]] | |||
=== Последовательная сложность алгоритма === | === Последовательная сложность алгоритма === | ||
1) Построение графа на основе метода k ближайших соседей в худшем случае требует <math>O(n^2)</math> операций; | |||
2) Для выделения множества сравнительно малых связных подграфов требуется <math>nm</math> операций; | |||
3) Формирование набора кластеров, на основе множества подграфов, полученных на предыдущем этапе, требует <math>m^2log(m)</math> операций. | |||
Итого, получаем последовательную сложность <math>O(n^2+nm+m^2log(m))</math>. | |||
=== Информационный граф === | === Информационный граф === | ||
[[File:Chameleon_inforgraph.png|811px]] | |||
=== Ресурс параллелизма алгоритма === | === Ресурс параллелизма алгоритма === | ||
Первый этап работы алгоритма можно распределить между <math>n</math> процессами: в этом случае каждому процессу назначается своя точка и происходит поиск <math>k</math> ближайших соседей. Таким образом, его параллельная сложность составляет <math>O(n)</math>. | |||
На втором этапе количество задействованных процессов может варьироваться в зависимости от входных данных. В худшем случае число итераций можно оценить как <math>O(log(n))</math>. | |||
На третьем этапе можно распараллелить процесс расчёта метрик сходства между кластерами, однако итоговое слияние всё равно должно выполняться последовательно. | |||
Поскольку процесс сравнения кластеров возможно распараллелить, сложность 3-го этапа составляет <math>mlog(m) + m^2log(m)</math>. | |||
Таким образом, суммарная параллельная сложность оказывается равна <math>O(n + log(n) + mlog(m) + m^2log(m))</math>. | |||
=== Входные и выходные данные алгоритма === | === Входные и выходные данные алгоритма === | ||
* Входные данные: | |||
1) Треугольная матрица <math>A</math> размера <math>n\times n</math> (где n — количество объектов), в которой элементу <math>a_{ij}</math> соответствует расстояние между i-м и j-м объектами. | |||
2) Количество ближайших соседей <math>k</math> для вершин (рекомендуемое значение <math>k</math> от 5 до 20 в зависимости от количества анализируемых объектов). | |||
3) Наименьшее число вершин, которое может содержать наибольший подграф на 2-м этапе <math>l</math>. Величина этого параметра варьируется от 1 до 5 % от общего числа объектов. | |||
* Объём входных данных: <math>\frac{n (n - 1)}{2}</math> | |||
* Выходные данные: n-мерный вектор <math>v</math>, в котором элементу <math>v_{i}</math> соответствует номер кластера, присвоенный i-му объекту | |||
* Объём выходных данных: <math>n</math> | |||
=== Свойства алгоритма === | === Свойства алгоритма === | ||
Первый этап алгоритма обладает хорошим ресурсом параллелизма: параллельная сложность его выполнения составляет <math>O(n)</math>, что намного лучше последовательной оценки <math>O(n^2)</math>. | |||
У второго и третьего этапов алгоритма сложно полностью оценить ресурсы параллелизма. Но оба этапа возможно частично распараллелить. | |||
'''Вычислительную мощность''' для разных этапов алгоритма можно оценить как: | |||
1 этап: <math>O(1)</math> | |||
2 этап: <math>O(\frac{nm}{n^2+m^2})</math> | |||
3 этап: <math>O(\frac{m^2log(m)}{m^2+n})</math> | |||
<b>Детерминированность:</b> Важной особенностью данного алгоритма является его недетерминированность. Несмотря на то, что 1-й этап детерминирован, алгоритм в целом является недетерминированным, так как на 2-ом этапе могут быть найдены различные разбиения на подграфы, а это повлияет и на итоговый результат работы алгоритма. | |||
== Программная реализация алгоритма == | |||
=== Особенности реализации последовательного алгоритма === | |||
=== Локальность данных и вычислений === | |||
=== Возможные способы и особенности параллельной реализации алгоритма === | |||
=== Масштабируемость алгоритма и его реализации === | |||
Проводилось исследование масштабируемости экспериментальной версии параллельной реализации алгоритма для малого числа потоков<ref name="tr">http://research.ijcaonline.org/volume79/number8/pxc3891600.pdf</ref>. | |||
Его результаты отражены на графиках. Из графиков видно, что ускорение и эффективность алгоритма растут с увеличением объема данных. | |||
Однако можно заметить, что с увеличением числа потоков эффективность алгоритма падает. | |||
[[File:Plot cham.jpg|850px|center]] | |||
[[File:Cham_speedup.png]] [[File:Cham_eff.png]] | |||
=== Динамические характеристики и эффективность реализации алгоритма === | |||
=== Выводы для классов архитектур === | |||
=== Существующие реализации алгоритма === | |||
Существует несколько последовательных реализаций алгоритма. С одной из них можно ознакомиться по ссылке <ref name="tra">http://www.codeforge.com/article/192925</ref>. | |||
Возможна реализация алгоритма CHAMELEON с использованием графовых библиотек, как, например METIS <ref name="tru">http://glaros.dtc.umn.edu/gkhome/metis/metis/overview</ref> , hMETIS <ref name="tri">http://glaros.dtc.umn.edu/gkhome/metis/hmetis/overview</ref> и RANN <ref name="tro">https://cran.r-project.org/web/packages/RANN/index.html</ref>. | |||
Параллельных реализаций алгоритма CHAMELEON найдено не было. Однако существует исследование, связанное с реализацией CHAMELEON посредством технологии OpenMP, с которым можно ознакомиться здесь <ref name="tr">http://research.ijcaonline.org/volume79/number8/pxc3891600.pdf</ref>. | |||
== Литература == | |||
<references \> | |||
Текущая версия от 14:31, 29 ноября 2016
| Файл:Symbol confirmed.svg | Эта работа успешно выполнена Преподавателю: в основное пространство, в подстраницу Данное задание было проверено и зачтено. Проверено Kronberg и Algoman. |
| Графо-ориентированный алгоритм кластеризации CHAMELEON | |
| Последовательный алгоритм | |
| Последовательная сложность | [math]\displaystyle{ O(n^2+nm+m^2log(m)) }[/math] |
| Объём входных данных | [math]\displaystyle{ \frac{n (n - 1)}{2} }[/math] |
| Объём выходных данных | [math]\displaystyle{ n }[/math] |
| Параллельный алгоритм | |
| Высота ярусно-параллельной формы | [math]\displaystyle{ O(n + log(n) + mlog(m) + m^2log(m)) }[/math] |
| Ширина ярусно-параллельной формы | [math]\displaystyle{ O(n) }[/math] |
Статью подготовили: Артём Таран Иванович (разделы 1.1 - 1.10, 2.7), Шимчик Никита Владимирович (разделы 1.1 - 1.10, 2.7).
Свойства и структура алгоритма
Общее описание алгоритма
Кластеризация — многомерная статистическая процедура, выполняющая сбор данных, содержащих информацию о выборке объектов, и затем упорядочивающая объекты в сравнительно однородные группы (кластеры) с минимизацией межкластерного сходства и максимизацией внутрикластерного сходства.
Графо-ориентированный алгоритм кластеризации CHAMELEON[1] - алгоритм, который измеряет сходство двух кластеров на основе динамической модели. В процессе кластеризации два кластера объединяются, только если показатели взаимосвязанности и близости между двумя кластерами являются высокими по отношению к показателям внутренней взаимосвязанности кластеров и близости элементов внутри этих кластеров. Процесс слияния с использованием динамической модели, использующийся в данном алгоритме облегчает открытие природных и однородных кластеров. Методология динамического моделирования кластеров, использующаяся в CHAMELEON, применима ко всем типам данных, для которых может быть построена матрица подобия.
Следует отметить, что конечное число кластеров не задаётся явным образом и зависит как от выбора параметров алгоритма, так и от внутренней структуры входных данных.
Алгоритм кластеризации CHAMELEON включает в себя три этапа:
1) Построение графа, путём добавления рёбер по принципу k ближайших соседей.
2) Выделение множества сравнительно малых связных подграфов.
3) Формирование набора кластеров, на основе множества подграфов, полученных на предыдущем этапе.
Математическое описание алгоритма
Данные
- Исходные данные: множество из [math]\displaystyle{ n }[/math] точек [math]\displaystyle{ V = \{v_{i}\} }[/math] в метрическом пространстве, которое может быть задано в виде треугольной матрицы расстояний [math]\displaystyle{ A }[/math] размера [math]\displaystyle{ n\times n }[/math]; натуральное число [math]\displaystyle{ k }[/math], используемое в качестве параметра алгоритма поиска k ближайших соседей.
- Промежуточный результат после первого этапа: граф [math]\displaystyle{ G = (V, E) }[/math], полученный путём соединения каждой точки с её [math]\displaystyle{ k }[/math] ближайшими соседями.
- Промежуточный результат после второго этапа: разбиение множества [math]\displaystyle{ V }[/math] на набор [math]\displaystyle{ K = \{K_{i}\} }[/math] попарно непересекающихся связных подмножеств, из которого образуется взвешенный граф [math]\displaystyle{ G_{2} = (K, E_{2}) }[/math].
- Промежуточный результат после третьего этапа: итоговое разбиение множества вершин графа [math]\displaystyle{ G_{2} }[/math] на набор кластеров [math]\displaystyle{ C = \{C_{i}\} }[/math].
- Вычисляемые данные: n-мерный вектор [math]\displaystyle{ v }[/math] (элементы [math]\displaystyle{ v_{i} }[/math]), показывающий отображение исходного множества точек на набор кластеров [math]\displaystyle{ C }[/math].
Определения
- Абсолютная взаимная связность между парой кластеров [math]\displaystyle{ C_{i} }[/math] и [math]\displaystyle{ C_{j} }[/math] определяется как сумма весов ребер, соединяющих вершины, принадлежащие [math]\displaystyle{ C_{i} }[/math] с вершинами из [math]\displaystyle{ C_{j} }[/math]. Эти ребра, фактически, входят в разделитель ребер графа, состоящего из кластеров [math]\displaystyle{ C_{i} }[/math] и [math]\displaystyle{ C_{j} }[/math], и разбивающим его на подграфы [math]\displaystyle{ C_{i} }[/math] и [math]\displaystyle{ C_{j} }[/math]. Обозначается эта величина как
[math]\displaystyle{ EC_{(C_{i},C_{j})} }[/math]. Внутреннюю связность [math]\displaystyle{ EC_{C_{i}} }[/math] кластера [math]\displaystyle{ C_{i} }[/math] можно вычислить как сумму ребер, входящих в разделитель ребер, разбивающий [math]\displaystyle{ C_{i} }[/math] на два совершенно равных подграфа.
- Относительная взаимная [math]\displaystyle{ RI_{(C_{i},C_{j})} }[/math] связность пары кластеров [math]\displaystyle{ C_{i} }[/math] и [math]\displaystyle{ C_{j} }[/math] определяется формулой:
[math]\displaystyle{ RI_{(C_{i},C_{j})} = \frac{2*|EC_{(C_{i},C_{j})}|}{|EC_{C_{i}}|+|EC_{C_{j}}|} }[/math]
Учитывая значения относительной взаимной связности, можно добиться получения кластеров разного размера, формы и плотности, то есть общего внутреннего сходства.
- Абсолютное взаимное сходство между парой кластеров [math]\displaystyle{ C_{i} }[/math] и [math]\displaystyle{ C_{j} }[/math] подсчитывается как среднее сходство между соединенными вершинами, принадлежащими [math]\displaystyle{ C_{i} }[/math] и [math]\displaystyle{ C_{j} }[/math] соответственно. Эти соединения обусловлены предыдущим разбиением общего графа, полученного на матрице сходства.
- Относительное взаимное сходство [math]\displaystyle{ RC_{(C_{i},C_{j})} }[/math] между парой кластеров [math]\displaystyle{ C_{i} }[/math] и [math]\displaystyle{ C_{j} }[/math] определяется как абсолютное сходство между этой парой кластеров, нормализованное с учетом их внутреннего сходства и вычисляется по формуле:
[math]\displaystyle{ RC_{(C_{i},C_{j})}= \frac{S_{EC_{(C_{i},C_{j})}}}{\frac{|C_{i}|}{|C_{i}+C_{j}|}*S_{EC_{(C_{i})}}+\frac{|C_{i}|}{|C_{i}+C_{j}|}*S_{EC_{(C_{j})}}} }[/math],
где [math]\displaystyle{ S_{EC_{(C_{i})}} }[/math] и [math]\displaystyle{ S_{EC_{(C_{i})}} }[/math] - средние веса ребер (значения сходства), принадлежащих разделителю ребер кластеров [math]\displaystyle{ C_{i} }[/math] и [math]\displaystyle{ C_{j} }[/math] соответственно, и [math]\displaystyle{ S_{EC_{(C_{i},C_{j})}} }[/math] - средний вес ребер, соединяющих вершины [math]\displaystyle{ C_{i} }[/math] с вершинами [math]\displaystyle{ C_{j} }[/math], причем ребра принадлежат разделителю ребер [math]\displaystyle{ EC_{(C_{i})} }[/math], определенному ранее.
Далее, алгоритм применяет агломеративную иерархическую кластеризацию с использованием вышеозначенных показателей. Причем существует две стратегии их учета. Первая подразумевает наличие некоторых пороговых значений [math]\displaystyle{ T_{RI} }[/math] и [math]\displaystyle{ T_{RC} }[/math]. В соответствии с этой стратегией, алгоритм для каждого кластера [math]\displaystyle{ C_{i} }[/math] проверяет, отвечают ли смежные (наиболее близкие) ему кластеры условиям:
- [math]\displaystyle{ RI_{(C_{i},C_{j})} \geqslant T_{RI} }[/math]
- [math]\displaystyle{ RC_{(C_{i},C_{j})} \geqslant T_{RC} }[/math]
Если более одного смежного кластера отвечает этим условиям, то алгоритм выбирает для объединения наиболее связный кластер (граф), то есть такой кластер [math]\displaystyle{ C_{j} }[/math], с которым у кластера [math]\displaystyle{ C_{i} }[/math] получается наибольшая абсолютная взаимная связность. По завершению прохода по всем кластерам, созданные таким образом пары объединяются. Параметры [math]\displaystyle{ T_{RI} }[/math] и [math]\displaystyle{ T_{RC} }[/math] могут использоваться для изменения характеристик получаемых кластеров.
Вторая стратегия заключается в использовании специальной функции, объединяющей понятия относительной взаимной связности и относительного взаимного сходства. На каждом шаге выбираются те кластеры для объединения, которые максимизируют эту функцию:
[math]\displaystyle{ RI_{(C_{i},C_{j})}*RC_{(C_{i},C_{j})}^\alpha }[/math],
где [math]\displaystyle{ \alpha }[/math] выбирается пользователем. Если [math]\displaystyle{ \alpha \gt 1 }[/math], то алгоритм придает большее значение относительному взаимному сходству, а если [math]\displaystyle{ \alpha \lt 1 }[/math], то большее значение имеет относительная взаимная связность. Разумеется, данный подход позволяет получить полную дендрограмму кластерного анализа[2].
Вычислительное ядро алгоритма
На первом этапе работы алгоритма вычислительным ядром можно считать процесс нахождения k ближайших соседей для каждой отдельной вершины.
На втором этапе работы алгоритма вычислительным ядром является поиск разбиения графа на два подграфа с минимизацией разделителя рёбер графа.
На третьем этапе работы алгоритма вычислительным ядром является расчёт [math]\displaystyle{ EC_{(C_{i},C_{j})} }[/math], [math]\displaystyle{ RC_{(C_{i},C_{j})} }[/math] и [math]\displaystyle{ RI_{(C_{i},C_{j})} }[/math] для пары смежных кластеров, а также их слияние.
Макроструктура алгоритма
Алгоритм CHAMELEON выполняется в 3 этапа, последовательных относительно друг друга. Каждый этап соответствует отдельному алгоритму.
- Макрооперацией на первом этапе является процедура выделения k ближайших соседей.
- Макрооперацией на втором этапе является процедура разбиения наибольшего подграфа на каждой итерации.
- Макрооперациями на третьем этапе являются процедуры вычисления метрики для принятия решения об объединении кластеров и объединение кластеров на каждой итерации.
Схема реализации последовательного алгоритма
- Первый этап (псевдокод):
 integer n; // Количество точек.
 integer k; // Параметр k
 integer A[n][n]; // Верхняя треугольная матрица расстояний между точками.

 integer E[n][n]; // Верхняя треугольная матрица рёбер графа G - изначально инициализирована нулями.
 foreach (integer i in (1,n-1) ) {
   integer Neighbours[k]; // матрица, используемая хранения ближайших соседей
   integer countN = 0;

   foreach (integer j in (i+1, n) ) {
     // Заполняем матрицу Neighbours, добавляя новые элементы и увеличивая счётчик countN.
     // Когда countN станет равен k, новые элементы будут вставляться на место старых, либо отбрасываться.
   }

   foreach (integer j in (0, countN) ) {
     E[min(i,j), max(i,j)] = 1;
   }
 }
 return E;
- Второй этап:

- Третий этап:

Последовательная сложность алгоритма
1) Построение графа на основе метода k ближайших соседей в худшем случае требует [math]\displaystyle{ O(n^2) }[/math] операций;
2) Для выделения множества сравнительно малых связных подграфов требуется [math]\displaystyle{ nm }[/math] операций;
3) Формирование набора кластеров, на основе множества подграфов, полученных на предыдущем этапе, требует [math]\displaystyle{ m^2log(m) }[/math] операций.
Итого, получаем последовательную сложность [math]\displaystyle{ O(n^2+nm+m^2log(m)) }[/math].
Информационный граф

Ресурс параллелизма алгоритма
Первый этап работы алгоритма можно распределить между [math]\displaystyle{ n }[/math] процессами: в этом случае каждому процессу назначается своя точка и происходит поиск [math]\displaystyle{ k }[/math] ближайших соседей. Таким образом, его параллельная сложность составляет [math]\displaystyle{ O(n) }[/math].
На втором этапе количество задействованных процессов может варьироваться в зависимости от входных данных. В худшем случае число итераций можно оценить как [math]\displaystyle{ O(log(n)) }[/math].
На третьем этапе можно распараллелить процесс расчёта метрик сходства между кластерами, однако итоговое слияние всё равно должно выполняться последовательно. Поскольку процесс сравнения кластеров возможно распараллелить, сложность 3-го этапа составляет [math]\displaystyle{ mlog(m) + m^2log(m) }[/math].
Таким образом, суммарная параллельная сложность оказывается равна [math]\displaystyle{ O(n + log(n) + mlog(m) + m^2log(m)) }[/math].
Входные и выходные данные алгоритма
- Входные данные:
1) Треугольная матрица [math]\displaystyle{ A }[/math] размера [math]\displaystyle{ n\times n }[/math] (где n — количество объектов), в которой элементу [math]\displaystyle{ a_{ij} }[/math] соответствует расстояние между i-м и j-м объектами.
2) Количество ближайших соседей [math]\displaystyle{ k }[/math] для вершин (рекомендуемое значение [math]\displaystyle{ k }[/math] от 5 до 20 в зависимости от количества анализируемых объектов).
3) Наименьшее число вершин, которое может содержать наибольший подграф на 2-м этапе [math]\displaystyle{ l }[/math]. Величина этого параметра варьируется от 1 до 5 % от общего числа объектов.
- Объём входных данных: [math]\displaystyle{ \frac{n (n - 1)}{2} }[/math]
- Выходные данные: n-мерный вектор [math]\displaystyle{ v }[/math], в котором элементу [math]\displaystyle{ v_{i} }[/math] соответствует номер кластера, присвоенный i-му объекту
- Объём выходных данных: [math]\displaystyle{ n }[/math]
Свойства алгоритма
Первый этап алгоритма обладает хорошим ресурсом параллелизма: параллельная сложность его выполнения составляет [math]\displaystyle{ O(n) }[/math], что намного лучше последовательной оценки [math]\displaystyle{ O(n^2) }[/math].
У второго и третьего этапов алгоритма сложно полностью оценить ресурсы параллелизма. Но оба этапа возможно частично распараллелить.
Вычислительную мощность для разных этапов алгоритма можно оценить как:
1 этап: [math]\displaystyle{ O(1) }[/math]
2 этап: [math]\displaystyle{ O(\frac{nm}{n^2+m^2}) }[/math]
3 этап: [math]\displaystyle{ O(\frac{m^2log(m)}{m^2+n}) }[/math]
Детерминированность: Важной особенностью данного алгоритма является его недетерминированность. Несмотря на то, что 1-й этап детерминирован, алгоритм в целом является недетерминированным, так как на 2-ом этапе могут быть найдены различные разбиения на подграфы, а это повлияет и на итоговый результат работы алгоритма.
Программная реализация алгоритма
Особенности реализации последовательного алгоритма
Локальность данных и вычислений
Возможные способы и особенности параллельной реализации алгоритма
Масштабируемость алгоритма и его реализации
Проводилось исследование масштабируемости экспериментальной версии параллельной реализации алгоритма для малого числа потоков[3].
Его результаты отражены на графиках. Из графиков видно, что ускорение и эффективность алгоритма растут с увеличением объема данных.
Однако можно заметить, что с увеличением числа потоков эффективность алгоритма падает.


Динамические характеристики и эффективность реализации алгоритма
Выводы для классов архитектур
Существующие реализации алгоритма
Существует несколько последовательных реализаций алгоритма. С одной из них можно ознакомиться по ссылке [4].
Возможна реализация алгоритма CHAMELEON с использованием графовых библиотек, как, например METIS [5] , hMETIS [6] и RANN [7].
Параллельных реализаций алгоритма CHAMELEON найдено не было. Однако существует исследование, связанное с реализацией CHAMELEON посредством технологии OpenMP, с которым можно ознакомиться здесь [3].
Литература
<references \>
- ↑ 1,0 1,1 http://www-users.cs.umn.edu/~han/dmclass/chameleon.pdf
- ↑ http://studopedia.ru/7_41934_algoritm-dinamicheskoy-ierarhicheskoy-klasterizatsii-CHAMELEON.html
- ↑ 3,0 3,1 http://research.ijcaonline.org/volume79/number8/pxc3891600.pdf
- ↑ http://www.codeforge.com/article/192925
- ↑ http://glaros.dtc.umn.edu/gkhome/metis/metis/overview
- ↑ http://glaros.dtc.umn.edu/gkhome/metis/hmetis/overview
- ↑ https://cran.r-project.org/web/packages/RANN/index.html