Участник:Anastasy/Алгоритм Диница: различия между версиями
Anastasy (обсуждение | вклад) |
Anastasy (обсуждение | вклад) |
||
| Строка 54: | Строка 54: | ||
=== Информационный граф === | === Информационный граф === | ||
<div><ul> | |||
[[ | <li style="display: inline-block;"> [[File:dinic.png|thumb|none|500px|Информационный граф для алгоритма Диница]] </li> | ||
<li style="display: inline-block;"> [[File:bfs.png|thumb|none|650px|Информационный граф для параллельной реализации поиска в ширину]] </li> | |||
</ul></div> | |||
=== Ресурс параллелизма алгоритма === | === Ресурс параллелизма алгоритма === | ||
Версия от 18:57, 27 ноября 2017
Алгоритм Диница
Автор: Киреева Анастасия, группа 416
Постановка задачи
Общее описание алгоритма
Алгоритм Диница [1] — полиномиальный алгоритм, предназначенный для поиска максимального потока в транспортной сети. Он был предложен советским учёным Ефимом Диницем в 1970 году. Временная сложность алгоритма [math]\displaystyle{ O(nm^2) }[/math], где [math]\displaystyle{ m }[/math] — число ребер, а [math]\displaystyle{ n }[/math] — число вершин.
Основная идея алгоритма состоит в том, чтобы итеративно увеличивать величину потока вдоль некоторых путей из истока в сток. Алгоритм Диница схож с алгоритмом Эдмондса-Карпа[2], но основное отличие можно понимать так: на каждой итерации поток увеличивается не вдоль одного кратчайшего пути из истока в сток, а вдоль целого набора таких путей.
Математическое описание алгоритма
Математическая постановка задачи приведена в статье "Поиск максимального потока в транспортной сети", мы будем использовать введённые в ней обозначения.
Введём необходимые определения.
Остаточной сетью [math]\displaystyle{ G^R }[/math] по отношению к сети [math]\displaystyle{ G=(V, E) }[/math] и некоторому потоку [math]\displaystyle{ f }[/math] в ней называется сеть, в которой каждому ребру [math]\displaystyle{ (u,v) \in E }[/math] с пропускной способностью [math]\displaystyle{ c_{uv} }[/math] и потоком [math]\displaystyle{ f_{uv} }[/math] соответствуют два ребра:
- [math]\displaystyle{ (u,v) }[/math] с пропускной способностью [math]\displaystyle{ c_{uv}^R = c_{uv} - f_{uv} }[/math]
- [math]\displaystyle{ (v,u) }[/math] с пропускной способностью [math]\displaystyle{ c_{vu}^R = f_{uv} }[/math]
Стоит отметить, что при таком определении в остаточной сети могут появляться кратные рёбра: если в исходной сети было как ребро [math]\displaystyle{ (u,v) }[/math], так и [math]\displaystyle{ (v,u) }[/math].
Блокирующим потоком в данной сети называется такой поток, что любой путь из истока [math]\displaystyle{ s }[/math] в сток [math]\displaystyle{ t }[/math] содержит насыщенное этим потоком ребро (то есть [math]\displaystyle{ c_{uv} = f_{uv} }[/math] для некоторых [math]\displaystyle{ u,v \in V }[/math]). Иными словами, в данной сети не найдётся такого пути из истока в сток, вдоль которого можно беспрепятственно увеличить поток.
Блокирующий поток не обязательно максимален. Согласно теореме Форда-Фалкерсона поток будет максимальным тогда и только тогда, когда в остаточной сети [math]\displaystyle{ G^R }[/math] не найдётся [math]\displaystyle{ s-t }[/math] пути; в блокирующем же потоке ничего не утверждается о существовании пути по рёбрам, появляющимся в остаточной сети.
Слоистая сеть для данной сети строится следующим образом. Сначала определяются длины кратчайших путей из истока [math]\displaystyle{ s }[/math] до всех остальных вершин; назовём уровнем [math]\displaystyle{ {\rm level}[v] }[/math] вершины её расстояние от истока. Тогда в слоистую сеть включают все те рёбра [math]\displaystyle{ (u,v) }[/math] исходной сети, для которых верно [math]\displaystyle{ {\rm level}[u] + 1 = {\rm level}[v] }[/math].
Слоистая сеть ациклична. Кроме того, любой [math]\displaystyle{ s-t }[/math] путь в слоистой сети является кратчайшим путём в исходной сети.
Алгоритм представляет собой несколько фаз. На каждой фазе сначала строится остаточная сеть, затем по отношению к ней строится слоистая сеть (обходом в ширину), а в ней ищется произвольный блокирующий поток. Найденный блокирующий поток прибавляется к текущему потоку, и на этом очередная итерация заканчивается. Алгоритм заканчивает свою работу, когда в построенной на некоторой итерации остаточной сети не найдётся [math]\displaystyle{ s-t }[/math] пути.
Вычислительное ядро алгоритма
Наибольший объем вычислений приходится на:
- поиск в ширину (для построения слоистой сети)
- обход в глубину (для построения блокирующего потока)
Макроструктура алгоритма
Одним из важных шагов алгоритма является поиск блокирующего потока. Опишем, каким образом это можно сделать.
Ищем [math]\displaystyle{ s-t }[/math] пути по одному обходом в глубину, пока такие пути находятся, при этом удаляем те ребра, вдоль которых невозможно дойти до стока. Для этого достаточно удалять ребро после того, как мы просмотрели его в обходе в глубину (кроме того случая, когда мы прошли вдоль ребра и нашли путь до стока). С точки зрения реализации, надо просто поддерживать в списке смежности каждой вершины указатель на первое неудалённое ребро, и увеличивать этот указатель в цикле внутри обхода в глубину.
Схема реализации последовательного алгоритма
Структуру алгоритма можно описать следующим образом:
- Для всех ребер [math]\displaystyle{ (u, v) \in E }[/math] сети [math]\displaystyle{ G }[/math] присвоим [math]\displaystyle{ f_{uv}=0 }[/math].
- Построим остаточную сеть [math]\displaystyle{ G^R }[/math] по отношению к сети [math]\displaystyle{ G }[/math] и потоку [math]\displaystyle{ f }[/math]. Затем строим слоистую сеть [math]\displaystyle{ G^L }[/math] по отношению к сети [math]\displaystyle{ G^R }[/math]. Если [math]\displaystyle{ {\rm level}[t]=∞ }[/math], алгоритм завершает работу и выводит поток [math]\displaystyle{ f }[/math].
- Ищем блокирующий поток [math]\displaystyle{ f' }[/math] в сети [math]\displaystyle{ G^R }[/math]
- Прибавим [math]\displaystyle{ f' }[/math] к потоку [math]\displaystyle{ f }[/math] и переходим к шагу 2.
Последовательная сложность алгоритма
- С помощью поиска в ширину слоистая сеть строится за время [math]\displaystyle{ O(m) }[/math].
- Если обход в глубину достигает стока, насыщается как минимум одно ребро, иначе как минимум один указатель продвигается вперед. Таким образом, один запуск обхода в глубину работает за [math]\displaystyle{ O(n + k) }[/math], где [math]\displaystyle{ k }[/math] — число продвижения указателей. Ввиду того, что всего запусков обхода в глубину в рамках поиска одного блокирующего потока будет [math]\displaystyle{ O(p) }[/math], где [math]\displaystyle{ p }[/math] — число рёбер, насыщенных этим блокирующим потоком, то весь алгоритм поиска блокирующего потока отработает за [math]\displaystyle{ O(pn + \sum\limits_i{k_i}) }[/math]. Учитывая, что все указатели в сумме прошли расстояние [math]\displaystyle{ O(m) }[/math], это дает асимптотику [math]\displaystyle{ O(pn + pk) }[/math]. В худшем случае, когда блокирующий поток насыщает все рёбра, асимптотика получается [math]\displaystyle{ O(mn) }[/math].
- Можно показать, что после каждой итерации расстояние между стоком и истоком строго увеличивается[1] (то есть [math]\displaystyle{ {\rm level'}[t] \gt {\rm level}[t] }[/math], где [math]\displaystyle{ {\rm level'}[t] }[/math] — расстояние до стока, полученное на следующей итерации). Так как длина кратчайшего [math]\displaystyle{ s-t }[/math] пути не может превосходить [math]\displaystyle{ n - 1 }[/math], то и количество фаз алгоритма не превосходит [math]\displaystyle{ n - 1 }[/math]. Таким образом, весь алгоритм Диница выполняется за [math]\displaystyle{ O(n^2m) }[/math].
Информационный граф
-
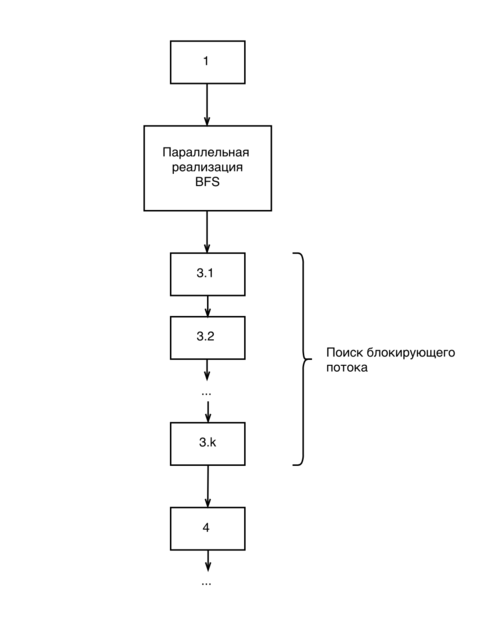
Информационный граф для алгоритма Диница -
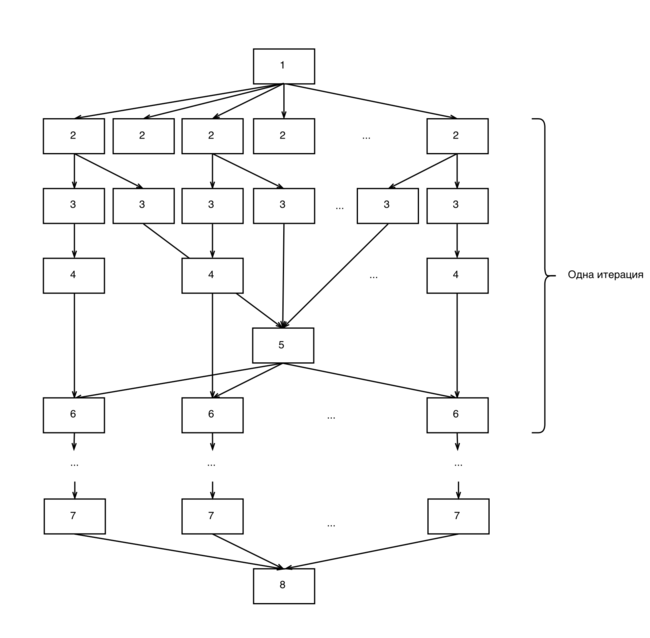
Информационный граф для параллельной реализации поиска в ширину


Ресурс параллелизма алгоритма
Входные и выходные данные алгоритма
Входные данные: Граф [math]\displaystyle{ G(V, E) }[/math]. [math]\displaystyle{ n }[/math] вершин [math]\displaystyle{ v_i }[/math] и [math]\displaystyle{ m }[/math] ребер [math]\displaystyle{ e_j = (v_j^{(1)}, v_j^{(2)}) }[/math] с заданной пропускной способностью [math]\displaystyle{ c_j }[/math], а также исток [math]\displaystyle{ s }[/math] и сток [math]\displaystyle{ t }[/math].
Объем входных данных: [math]\displaystyle{ O(m + n) }[/math].
Выходные данные: величина максимального потока.
Объем выходных данных: [math]\displaystyle{ O(1) }[/math].
Свойства алгоритма
Программная реализация алгоритма
Особенности реализации последовательного алгоритма
Локальность данных и вычислений
Возможные способы и особенности параллельной реализации алгоритма
Масштабируемость алгоритма и его реализации
Динамические характеристики и эффективность реализации алгоритма
Выводы для классов архитектур
Существующие реализации алгоритма
Литература
- ↑ 1,0 1,1 Диниц, Е. А. “Алгоритм решения задачи о максимальном потоке в сети со степенной оценкой.” Доклады АН СССР 194, no. 4 (1970): 754–57
- ↑ Edmonds, Jack; Karp, Richard M. (1972). "Theoretical improvements in algorithmic efficiency for network flow problems". Journal of the ACM. Association for Computing Machinery