
Метод релаксации матрицы: различия между версиями
| [непроверенная версия] | [непроверенная версия] |
Новая страница: «''417 группа, ММП ВМК МГУ''<br> ''Овсиенко Олеся Павловна''<br> == Математическая постановка мето...» |
Нет описания правки |
||
| Строка 1: | Строка 1: | ||
== | {{algorithm | ||
| name = Метод релаксации для уравнения Лапласа | |||
| serial_complexity = <math>O(it\_max \cdot N^2)</math> | |||
| pf_height = <math>O(it\_max)</math> | |||
| pf_width = <math>O(N^2)</math> | |||
| input_data = <math>N^2</math> (матрица значений) | |||
| output_data = <math>N^2</math> (матрица значений) | |||
}} | |||
== Свойства и структура алгоритма == | |||
=== Общее описание алгоритма === | |||
Метод релаксации является одним из простейших итерационных методов решения уравнений в частных производных. В данной реализации он применяется для численного решения уравнения Лапласа на прямоугольной области с граничными условиями Дирихле. Алгоритм основан на дискретизации уравнения с использованием конечно-разностной схемы и последующем итеративном обновлении значений в узлах сетки до достижения заданной точности. | |||
Метод широко используется в вычислительной физике для решения стационарных задач, таких как распределение потенциала, тепловое равновесие и др. Благодаря простоте реализации и естественному параллелизму (каждая точка сетки обновляется независимо на каждой итерации) алгоритм хорошо подходит для распараллеливания на многопроцессорных системах. | |||
=== Математическое описание алгоритма === | |||
Исходная задача: решение уравнения Лапласа | |||
<math> | <math> | ||
\frac{\partial^2 u}{\partial x^2} + \frac{\partial^2 u}{\partial y^2} = 0 | \frac{\partial^2 u}{\partial x^2} + \frac{\partial^2 u}{\partial y^2} = 0 | ||
</math> | </math> | ||
в прямоугольной области <math>[0,1]\times[0,1]</math> с нулевыми граничными условиями. | |||
с | Дискретизация на равномерной сетке <math>N \times N</math> с шагом <math>h = 1/(N-1)</math> приводит к системе линейных уравнений, которая решается методом Якоби: | ||
Для каждого внутреннего узла <math>(i,j)</math> на итерации <math>k</math>: | |||
<math> | <math> | ||
u_{i,j}^{(k)} = \frac{u_{i-1,j}^{(k-1)} + u_{i+1,j}^{(k-1)} + u_{i,j-1}^{(k-1)} + u_{i,j+1}^{(k-1)}}{4} | |||
</math> | </math> | ||
Критерий остановки: | |||
<math> | |||
\max_{i,j} |u_{i,j}^{(k)} - u_{i,j}^{(k-1)}| < \varepsilon_{\text{max}} | |||
</math> | |||
Начальное приближение для внутренних точек: | |||
<math> | |||
u_{i,j}^{(0)} = 1 + i + j | |||
</math> | |||
Контрольная сумма для верификации: | |||
<math> | <math> | ||
S = \frac{1}{N^2} \sum_{i=0}^{N-1} \sum_{j=0}^{N-1} u_{i,j} \cdot (i+1) \cdot (j+1) | |||
</math> | </math> | ||
=== Вычислительное ядро алгоритма === | |||
Вычислительное ядро алгоритма состоит из операций обновления значений во внутренних узлах сетки: | |||
<math> | <math> | ||
\frac{ | \text{new_val} = \frac{\text{left} + \text{right} + \text{top} + \text{bottom}}{4} | ||
</math> | </math> | ||
Для каждой внутренней точки на каждой итерации выполняется: | |||
* 4 чтения значений соседей | |||
* 3 операции сложения | |||
* 1 операция деления | |||
* 1 запись нового значения | |||
* 1 операция вычисления погрешности (разности между старым и новым значением) | |||
=== Макроструктура алгоритма === | |||
Алгоритм имеет итерационную структуру: | |||
# Инициализация матрицы (граничные условия + начальное приближение) | |||
# Для каждой итерации: | |||
## Вычисление новых значений для всех внутренних точек (релаксация) | |||
## Обновление матрицы | |||
## Вычисление максимальной погрешности | |||
## Проверка условия сходимости | |||
# Вычисление контрольной суммы | |||
=== Схема реализации последовательного алгоритма === | |||
* Инициализация матрицы A граничными условиями и начальными значениями, инициализация матрицы B нулями. | |||
* Цикл по итерациям: | |||
```c | |||
for (it = 1; it <= itmax; it++) { | |||
eps = 0.0; | |||
relax(); // Вычисление B[i][j] как среднее соседей из A | |||
resid(); // Обновление A[i][j] = B[i][j], вычисление погрешности | |||
if (eps < maxeps) break; | |||
} | |||
``` | |||
* Вычисление и вывод контрольной суммы | |||
=== Последовательная сложность алгоритма === | |||
Для сетки размером <math>N \times N</math>: | |||
* Каждая итерация требует <math>O(N^2)</math> операций | |||
* Количество итераций зависит от сходимости, ограничено `itmax` | |||
* Общая сложность: <math>O(it\_max \cdot N^2)</math> | |||
Конкретно для каждой внутренней точки на каждой итерации: | |||
* 4 операции чтения | |||
* 3 сложения | |||
* 1 деление | |||
* 1 запись | |||
* 1 вычитание и взятие модуля для погрешности | |||
=== Информационный граф === | |||
Граф алгоритма представляет собой регулярную структуру: | |||
<gallery> | |||
File:information_graph.png|Информационный граф метода релаксации для <math>N</math> = 4, <math>max\_it</math> = 2 | |||
</gallery> | |||
=== Ресурс параллелизма алгоритма === | |||
Алгоритм обладает высоким потенциалом параллелизма: | |||
* На каждой итерации все внутренние точки могут обновляться независимо | |||
* Высота ЯПФ: <math>O(it\_max)</math> (последовательные итерации) | |||
* Ширина ЯПФ: <math>O(N^2)</math> (все точки могут обрабатываться параллельно на одной итерации) | |||
В MPI-реализации: | |||
* Сетка разбивается на горизонтальные полосы | |||
* Каждый процесс обрабатывает свою полосу | |||
* Необходим обмен граничными строками между соседними процессами | |||
* Используются неблокирующие операции MPI для перекрытия вычислений и коммуникаций | |||
=== Входные и выходные данные алгоритма === | |||
Входные данные: | |||
* Размер сетки <math>N</math> (целое число) | |||
* Матрица значений <math>A</math> размером <math>N \times N</math> (вещественные числа) | |||
* Параметры: maxeps (точность), itmax (максимальное число итераций) | |||
Выходные данные: | |||
* Матрица <math>A</math> с решением (вещественные числа) | |||
* Контрольная сумма <math>S</math> (вещественное число) | |||
* Число выполненных итераций (целое) | |||
* Время выполнения (в параллельной версии) | |||
Объём данных: <math>O(N^2)</math> | |||
=== Свойства алгоритма === | |||
# Детерминированность: При фиксированных входных данных и последовательном выполнении результат детерминирован. | |||
# Сходимость: Метод сходится медленно (линейно), количество итераций пропорционально <math>N^2</math> для достижения заданной точности. | |||
# Устойчивость: Алгоритм устойчив к ошибкам округления. | |||
# Масштабируемость: Хорошо масштабируется на параллельных системах благодаря локальности данных. | |||
# Вычислительная мощность: Отношение числа операций к объёму данных составляет <math>O(it\_max)</math>. | |||
== Программная реализация алгоритма == | |||
=== Особенности реализации последовательного алгоритма === | |||
В последовательной реализации: | |||
# Используются две матрицы <math>A</math> и <math>B</math> для хранения значений на текущей и предыдущей итерациях. | |||
# Граничные условия заданы нулевыми. | |||
# Начальное приближение: <math>A[i][j] = 1.0 + i + j</math> для внутренних точек. | |||
# Реализован режим вычисления максимальной погрешности для контроля сходимости. | |||
# Контрольная сумма вычисляется по формуле, включающей веса <math>(i+1)(j+1)</math>. | |||
Ключевые особенности: | |||
```c | |||
// Вычисление нового значения | |||
B[i][j] = (A[i-1][j] + A[i+1][j] + A[i][j-1] + A[i][j+1]) / 4.0; | |||
// Обновление и вычисление погрешности | |||
e = fabs(A[i][j] - B[i][j]); | |||
A[i][j] = B[i][j]; | |||
eps = Max(eps, e); | |||
``` | |||
=== Возможные способы и особенности параллельной реализации алгоритма === | |||
MPI-реализация включает следующие особенности: | |||
* Разбиение данных: Сетка разбивается на горизонтальные полосы, каждая обрабатывается отдельным процессом. | |||
* Распределение нагрузки: При неравномерном разбиении (когда <math>N</math> не кратно числу процессов) первые процессы получают на одну строку больше. | |||
* Обмен граничными данными: Используются неблокирующие операции <math>MPI\_Isend / MPI\_Irecv</math> для перекрытия вычислений и коммуникаций. | |||
* Вычисление погрешности: Локальные погрешности собираются с помощью <math>MPI\_Allreduce</math> для нахождения глобального максимума. | |||
* Вычисление контрольной суммы: Частичные суммы вычисляются на каждом процессе и собираются с помощью <math>MPI\_Reduce</math>. | |||
```c | |||
// Обмен граничными строками | |||
if (rank > 0) { | |||
MPI_Irecv(localA[0], N, MPI_FLOAT, rank-1, 0, MPI_COMM_WORLD, &req[req_count++]); | |||
MPI_Isend(localA[1], N, MPI_FLOAT, rank-1, 0, MPI_COMM_WORLD, &req[req_count++]); | |||
} | |||
if (rank < size-1) { | |||
MPI_Irecv(localA[local_rows+1], N, MPI_FLOAT, rank+1, 0, MPI_COMM_WORLD, &req[req_count++]); | |||
MPI_Isend(localA[local_rows], N, MPI_FLOAT, rank+1, 0, MPI_COMM_WORLD, &req[req_count++]); | |||
} | |||
``` | |||
* Оптимизация: Пропуск вычислений для граничных строк на первом и последнем процессах. | |||
* Измерение времени: Использование <math>MPI\_Wtime</math> для точного измерения времени выполнения. | |||
=== | === Результаты прогонов=== | ||
Для получения полных результатов необходимо провести серию экспериментов с различными: | |||
# Размерами сетки ( <math>N</math> = 512, 1024, 2048, 4096 ) | |||
# Количеством процессов ( 1, 2, 3, ... , 28 ) | |||
# Параметрами точности ( <math>maxeps</math> = 0.1e-7 ) | |||
Результаты: | |||
* Ускорение работы с ростом числа процессов (до определённого предела) | |||
* Увеличение времени выполнения с ростом N | |||
* Зависимость числа итераций от точности и размера сетки | |||
* Накладные расходы на коммуникации в MPI-версии | |||
== Литература == | |||
1. Самарский А.А., Николаев Е.С. Методы решения сеточных уравнений. — М.: Наука, 1978. | |||
2. Press W.H., Teukolsky S.A., Vetterling W.T., Flannery B.P. Numerical Recipes: The Art of Scientific Computing. — 3rd ed. — Cambridge University Press, 2007. | |||
3. Gropp W., Lusk E., Skjellum A. Using MPI: Portable Parallel Programming with the Message-Passing Interface. — 3rd ed. — MIT Press, 2014. | |||
4. Документация по MPI: https://www.mpi-forum.org/docs/ | |||
Версия от 00:18, 9 декабря 2025
| Метод релаксации для уравнения Лапласа | |
| Последовательный алгоритм | |
| Последовательная сложность | [math]\displaystyle{ O(it\_max \cdot N^2) }[/math] |
| Объём входных данных | [math]\displaystyle{ N^2 }[/math] (матрица значений) |
| Объём выходных данных | [math]\displaystyle{ N^2 }[/math] (матрица значений) |
| Параллельный алгоритм | |
| Высота ярусно-параллельной формы | [math]\displaystyle{ O(it\_max) }[/math] |
| Ширина ярусно-параллельной формы | [math]\displaystyle{ O(N^2) }[/math] |
Свойства и структура алгоритма
Общее описание алгоритма
Метод релаксации является одним из простейших итерационных методов решения уравнений в частных производных. В данной реализации он применяется для численного решения уравнения Лапласа на прямоугольной области с граничными условиями Дирихле. Алгоритм основан на дискретизации уравнения с использованием конечно-разностной схемы и последующем итеративном обновлении значений в узлах сетки до достижения заданной точности.
Метод широко используется в вычислительной физике для решения стационарных задач, таких как распределение потенциала, тепловое равновесие и др. Благодаря простоте реализации и естественному параллелизму (каждая точка сетки обновляется независимо на каждой итерации) алгоритм хорошо подходит для распараллеливания на многопроцессорных системах.
Математическое описание алгоритма
Исходная задача: решение уравнения Лапласа [math]\displaystyle{ \frac{\partial^2 u}{\partial x^2} + \frac{\partial^2 u}{\partial y^2} = 0 }[/math] в прямоугольной области [math]\displaystyle{ [0,1]\times[0,1] }[/math] с нулевыми граничными условиями.
Дискретизация на равномерной сетке [math]\displaystyle{ N \times N }[/math] с шагом [math]\displaystyle{ h = 1/(N-1) }[/math] приводит к системе линейных уравнений, которая решается методом Якоби:
Для каждого внутреннего узла [math]\displaystyle{ (i,j) }[/math] на итерации [math]\displaystyle{ k }[/math]: [math]\displaystyle{ u_{i,j}^{(k)} = \frac{u_{i-1,j}^{(k-1)} + u_{i+1,j}^{(k-1)} + u_{i,j-1}^{(k-1)} + u_{i,j+1}^{(k-1)}}{4} }[/math]
Критерий остановки: [math]\displaystyle{ \max_{i,j} |u_{i,j}^{(k)} - u_{i,j}^{(k-1)}| \lt \varepsilon_{\text{max}} }[/math]
Начальное приближение для внутренних точек: [math]\displaystyle{ u_{i,j}^{(0)} = 1 + i + j }[/math]
Контрольная сумма для верификации: [math]\displaystyle{ S = \frac{1}{N^2} \sum_{i=0}^{N-1} \sum_{j=0}^{N-1} u_{i,j} \cdot (i+1) \cdot (j+1) }[/math]
Вычислительное ядро алгоритма
Вычислительное ядро алгоритма состоит из операций обновления значений во внутренних узлах сетки: [math]\displaystyle{ \text{new_val} = \frac{\text{left} + \text{right} + \text{top} + \text{bottom}}{4} }[/math]
Для каждой внутренней точки на каждой итерации выполняется:
- 4 чтения значений соседей
- 3 операции сложения
- 1 операция деления
- 1 запись нового значения
- 1 операция вычисления погрешности (разности между старым и новым значением)
Макроструктура алгоритма
Алгоритм имеет итерационную структуру:
- Инициализация матрицы (граничные условия + начальное приближение)
- Для каждой итерации:
- Вычисление новых значений для всех внутренних точек (релаксация)
- Обновление матрицы
- Вычисление максимальной погрешности
- Проверка условия сходимости
- Вычисление контрольной суммы
Схема реализации последовательного алгоритма
- Инициализация матрицы A граничными условиями и начальными значениями, инициализация матрицы B нулями.
- Цикл по итерациям:
  ```c
  for (it = 1; it <= itmax; it++) {
      eps = 0.0;
      relax();     // Вычисление B[i][j] как среднее соседей из A
      resid();     // Обновление A[i][j] = B[i][j], вычисление погрешности
      if (eps < maxeps) break;
  }
  ```
- Вычисление и вывод контрольной суммы
Последовательная сложность алгоритма
Для сетки размером [math]\displaystyle{ N \times N }[/math]:
- Каждая итерация требует [math]\displaystyle{ O(N^2) }[/math] операций
- Количество итераций зависит от сходимости, ограничено `itmax`
- Общая сложность: [math]\displaystyle{ O(it\_max \cdot N^2) }[/math]
Конкретно для каждой внутренней точки на каждой итерации:
- 4 операции чтения
- 3 сложения
- 1 деление
- 1 запись
- 1 вычитание и взятие модуля для погрешности
Информационный граф
Граф алгоритма представляет собой регулярную структуру:
-
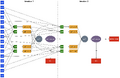 Информационный граф метода релаксации для [math]\displaystyle{ N }[/math] = 4, [math]\displaystyle{ max\_it }[/math] = 2

Ресурс параллелизма алгоритма
Алгоритм обладает высоким потенциалом параллелизма:
- На каждой итерации все внутренние точки могут обновляться независимо
- Высота ЯПФ: [math]\displaystyle{ O(it\_max) }[/math] (последовательные итерации)
- Ширина ЯПФ: [math]\displaystyle{ O(N^2) }[/math] (все точки могут обрабатываться параллельно на одной итерации)
В MPI-реализации:
- Сетка разбивается на горизонтальные полосы
- Каждый процесс обрабатывает свою полосу
- Необходим обмен граничными строками между соседними процессами
- Используются неблокирующие операции MPI для перекрытия вычислений и коммуникаций
Входные и выходные данные алгоритма
Входные данные:
- Размер сетки [math]\displaystyle{ N }[/math] (целое число)
- Матрица значений [math]\displaystyle{ A }[/math] размером [math]\displaystyle{ N \times N }[/math] (вещественные числа)
- Параметры: maxeps (точность), itmax (максимальное число итераций)
Выходные данные:
- Матрица [math]\displaystyle{ A }[/math] с решением (вещественные числа)
- Контрольная сумма [math]\displaystyle{ S }[/math] (вещественное число)
- Число выполненных итераций (целое)
- Время выполнения (в параллельной версии)
Объём данных: [math]\displaystyle{ O(N^2) }[/math]
Свойства алгоритма
- Детерминированность: При фиксированных входных данных и последовательном выполнении результат детерминирован.
- Сходимость: Метод сходится медленно (линейно), количество итераций пропорционально [math]\displaystyle{ N^2 }[/math] для достижения заданной точности.
- Устойчивость: Алгоритм устойчив к ошибкам округления.
- Масштабируемость: Хорошо масштабируется на параллельных системах благодаря локальности данных.
- Вычислительная мощность: Отношение числа операций к объёму данных составляет [math]\displaystyle{ O(it\_max) }[/math].
Программная реализация алгоритма
Особенности реализации последовательного алгоритма
В последовательной реализации:
- Используются две матрицы [math]\displaystyle{ A }[/math] и [math]\displaystyle{ B }[/math] для хранения значений на текущей и предыдущей итерациях.
- Граничные условия заданы нулевыми.
- Начальное приближение: [math]\displaystyle{ A[i][j] = 1.0 + i + j }[/math] для внутренних точек.
- Реализован режим вычисления максимальной погрешности для контроля сходимости.
- Контрольная сумма вычисляется по формуле, включающей веса [math]\displaystyle{ (i+1)(j+1) }[/math].
Ключевые особенности:
   ```c
   // Вычисление нового значения
   B[i][j] = (A[i-1][j] + A[i+1][j] + A[i][j-1] + A[i][j+1]) / 4.0;
   // Обновление и вычисление погрешности
   e = fabs(A[i][j] - B[i][j]);
   A[i][j] = B[i][j];
   eps = Max(eps, e);
   ```
Возможные способы и особенности параллельной реализации алгоритма
MPI-реализация включает следующие особенности:
- Разбиение данных: Сетка разбивается на горизонтальные полосы, каждая обрабатывается отдельным процессом.
- Распределение нагрузки: При неравномерном разбиении (когда [math]\displaystyle{ N }[/math] не кратно числу процессов) первые процессы получают на одну строку больше.
- Обмен граничными данными: Используются неблокирующие операции [math]\displaystyle{ MPI\_Isend / MPI\_Irecv }[/math] для перекрытия вычислений и коммуникаций.
- Вычисление погрешности: Локальные погрешности собираются с помощью [math]\displaystyle{ MPI\_Allreduce }[/math] для нахождения глобального максимума.
- Вычисление контрольной суммы: Частичные суммы вычисляются на каждом процессе и собираются с помощью [math]\displaystyle{ MPI\_Reduce }[/math].
   ```c
   // Обмен граничными строками
   if (rank > 0) {
       MPI_Irecv(localA[0], N, MPI_FLOAT, rank-1, 0, MPI_COMM_WORLD, &req[req_count++]);
       MPI_Isend(localA[1], N, MPI_FLOAT, rank-1, 0, MPI_COMM_WORLD, &req[req_count++]);
   }
   if (rank < size-1) {
       MPI_Irecv(localA[local_rows+1], N, MPI_FLOAT, rank+1, 0, MPI_COMM_WORLD, &req[req_count++]);
       MPI_Isend(localA[local_rows], N, MPI_FLOAT, rank+1, 0, MPI_COMM_WORLD, &req[req_count++]);
   }
   ```
- Оптимизация: Пропуск вычислений для граничных строк на первом и последнем процессах.
- Измерение времени: Использование [math]\displaystyle{ MPI\_Wtime }[/math] для точного измерения времени выполнения.
Результаты прогонов
Для получения полных результатов необходимо провести серию экспериментов с различными:
- Размерами сетки ( [math]\displaystyle{ N }[/math] = 512, 1024, 2048, 4096 )
- Количеством процессов ( 1, 2, 3, ... , 28 )
- Параметрами точности ( [math]\displaystyle{ maxeps }[/math] = 0.1e-7 )
Результаты:
- Ускорение работы с ростом числа процессов (до определённого предела)
- Увеличение времени выполнения с ростом N
- Зависимость числа итераций от точности и размера сетки
- Накладные расходы на коммуникации в MPI-версии
Литература
1. Самарский А.А., Николаев Е.С. Методы решения сеточных уравнений. — М.: Наука, 1978.
2. Press W.H., Teukolsky S.A., Vetterling W.T., Flannery B.P. Numerical Recipes: The Art of Scientific Computing. — 3rd ed. — Cambridge University Press, 2007.
3. Gropp W., Lusk E., Skjellum A. Using MPI: Portable Parallel Programming with the Message-Passing Interface. — 3rd ed. — MIT Press, 2014.
4. Документация по MPI: https://www.mpi-forum.org/docs/